La recomendación inmediata: mide tus tokens reales por sesión y proyecta esa cifra al volumen mensual antes de firmar cualquier presupuesto de automatización.
En resumen:
- La tarifa por 1.000 tokens oscila entre 0,002 € en modelos económicos y varias veces más en modelos de frontera con mayor capacidad de razonamiento.
- Los tokens de salida generalmente cuestan varias veces más que los de entrada, haciendo que las respuestas largas aumenten significativamente el gasto total.
- El coste de un agente IA en producción puede multiplicar entre 1,5 y 3 veces la tarifa base de la API para cubrir infraestructura, reintentos y mantenimiento.
- Multiplicar el volumen mensual estimado por el coste por interacción y aplicar un margen de 2x a 3x proporciona una proyección realista del gasto total.
- Diseñar flujos eficientes, limitar pasos y usar modelos ligeros en tareas simples ayuda a reducir costos sin afectar la experiencia del usuario.
Tabla de contenidos
- Modelos de precios: tokens, tarifas por 1K y 1M, y por qué la salida cuesta más
- Fórmula y ejemplo para calcular el coste por interacción
- Cuánto cuesta una interacción con IA frente a una interacción humana
- Los gastos ocultos que encarecen un agente en producción
- Cómo reducir el coste por interacción sin bajar la calidad
- Cómo proyectar el ROI de un agente IA a escala
- Lo que muestran los casos reales de Anunzi en producción
- Lo que la mayoría de guías sobre coste de IA no te dicen
- Prueba tu propio caso antes de comprometer presupuesto
- Fuentes
- Preguntas frecuentes
Modelos de precios: tokens, tarifas por 1K y 1M, y por qué la salida cuesta más
Un token no es una palabra. Es un fragmento de texto, normalmente entre tres y cuatro caracteres en español, así que una regla práctica útil es contar unos 130 tokens por cada 100 palabras. Esa aproximación sirve para hacer números rápidos antes de pedir presupuestos exactos a un proveedor.
Los proveedores de modelos publican sus tarifas por cada 1.000 tokens (1K) o por cada 1.000.000 de tokens (1M), y conviene saber convertir entre ambas unidades sin errores. Si una tarifa cuesta 2 € por 1M tokens, el coste por 1K tokens es de 0,002 €. Parece un matiz menor, pero al multiplicar por miles de interacciones diarias, un error de conversión de una coma desplaza el presupuesto en varios órdenes de magnitud.
Casi todos los modelos cobran distinto por lo que entra y por lo que sale. Los tokens de salida suelen costar varias veces más que los de entrada, según muestran las calculadoras públicas de coste de agentes IA. Esto tiene una consecuencia directa en el diseño de producto: un agente que genera respuestas largas y detalladas siempre será más caro que uno que responde con brevedad, incluso con el mismo volumen de preguntas de entrada.
Las comparativas de coste de API de IA distinguen tres niveles:
- Modelos ligeros, pensados para tareas simples de clasificación o extracción, con tarifas mínimas por 1M tokens.
- Modelos intermedios, el punto medio entre coste y capacidad de razonamiento para la mayoría de agentes conversacionales.
- Modelos de frontera, con la mayor precisión y también el precio más alto, reservados para tareas que exigen razonamiento complejo.
Elegir el nivel correcto para cada tarea, en lugar de usar el modelo más potente para todo, es la primera palanca de ahorro antes de tocar ninguna configuración técnica.
Fórmula y ejemplo para calcular el coste por interacción
La fórmula base es simple: coste por interacción = (tokens de entrada × precio por token de entrada) + (tokens de salida × precio por token de salida). El reto está en tener las tarifas en la misma unidad antes de multiplicar, porque mezclar precios por 1K con volúmenes en millones es el error de cálculo más común entre equipos que presupuestan por primera vez.
Las calculadoras de coste de tokens convierten automáticamente precios por 1M a coste por llamada, y ese mismo cálculo puede reproducirse a mano con una tabla como esta:
| Concepto | Valor de ejemplo |
|---|---|
| Tokens de entrada por interacción | 800 |
| Tokens de salida por interacción | 400 |
| Precio entrada (por 1M tokens) | 3,00 € |
| Precio salida (por 1M tokens) | 15,00 € |
| Coste de entrada | 0,0024 € |
| Coste de salida | 0,006 € |
| Coste total por interacción | 0,0084 € |
En este ejemplo, cada interacción cuesta menos de un céntimo de euro en concepto de API. El problema no es esa cifra aislada, sino lo que ocurre al multiplicarla: 10.000 interacciones mensuales suman 84 € solo en tokens, antes de sumar infraestructura, herramientas externas y mantenimiento. Ese salto de la unidad al volumen es exactamente donde muchos presupuestos se quedan cortos, y es la razón por la que conviene proyectar desde el primer día con el volumen real esperado, no con una muestra de prueba.
Cuánto cuesta una interacción con IA frente a una interacción humana
Un agente de voz o chat con tareas simples, como confirmar una cita o responder una pregunta frecuente, suele costar una cantidad baja por sesión completa incluyendo API e infraestructura básica. Un agente con tareas complejas, que necesita consultar varios sistemas o mantener contexto largo, puede llegar a una cantidad significativa por sesión.
El coste de un agente humano se calcula distinto: hay que anualizar salario, cargas sociales, formación y supervisión, y dividir entre el volumen de interacciones que esa persona atiende.
Los puntos de equilibrio aparecen claros por sector:
- En atención de primer nivel (consultas repetitivas, agendamiento, estados de cuenta), la IA gana por volumen desde el primer mes de operación.
- En cobranzas con guiones estructurados, el ahorro se nota sobre todo en el horario nocturno y fines de semana, cuando un humano no está disponible pero la demanda no se detiene.
- En casos que exigen negociación compleja o juicio ético, el humano sigue siendo insustituible y la IA funciona mejor como filtro previo, no como reemplazo total.
La ventaja económica de la IA no viene de que cada interacción sea “gratis”, sino de que su coste marginal apenas crece con el volumen, mientras que el coste humano crece de forma casi lineal con cada persona contratada.
Los gastos ocultos que encarecen un agente en producción
El precio del token dejó de ser un detalle técnico y se convirtió en un indicador estratégico que los equipos de operaciones deben vigilar de cerca, porque el coste de la API es solo una parte de la factura final.
Los componentes que suelen quedar fuera de la primera estimación incluyen:
- Infraestructura de hosting y bases de datos vectoriales para búsqueda semántica y memoria de contexto.
- Herramientas externas conectadas por tool calls, cada una con su propio coste de uso y latencia.
- Reintentos por errores de red o respuestas inválidas, que duplican el consumo de tokens en esa interacción.
- Desarrollo inicial, monitoreo continuo y mantenimiento de los flujos conversacionales.
Cada tool call que un agente ejecuta añade tokens al historial que se envía en la siguiente llamada, y esa acumulación hace que el coste crezca de forma superlineal a medida que una conversación se alarga. Un agente que necesita cinco pasos para resolver un caso no cuesta cinco veces lo que cuesta uno de un paso: suele costar más, porque cada paso arrastra el contexto acumulado de los anteriores.
Por eso las guías del sector recomiendan aplicar un multiplicador moderado sobre el coste directo de la API al presupuestar un agente en producción, para cubrir ese overhead operativo sin sorpresas a mitad de mes.
Consejo profesional: Antes de firmar cualquier contrato de agente IA, pide al proveedor el desglose de coste por sesión en un escenario con tool calls activados, no solo el precio base por token. La diferencia entre ambos números suele ser la parte del presupuesto que nadie anticipa.
Cómo reducir el coste por interacción sin bajar la calidad
Existen palancas concretas que reducen el gasto operativo sin tocar la experiencia que recibe el cliente final. Aplicarlas en este orden suele dar el mejor retorno:
- Activa prompt caching: reutiliza el contexto que no cambia entre llamadas (instrucciones del sistema, base de conocimiento) para no pagar por procesarlo cada vez.
- Usa batch APIs para tareas que no requieren respuesta inmediata, como clasificar tickets acumulados durante la noche; suelen tener tarifas reducidas frente a llamadas en tiempo real.
- Comprime el historial de conversación: resume los turnos antiguos en lugar de enviarlos completos en cada nueva llamada.
- Limita el número de pasos que un agente puede dar antes de escalar a un humano, para evitar bucles de tool calls que inflan el coste sin resolver el caso.
- Asigna modelos ligeros a subtareas simples (clasificación, extracción de datos) y reserva los modelos de frontera solo para el razonamiento que realmente lo necesita.
El impacto de combinar prompt caching con batch APIs puede ser considerable en operaciones de alto volumen, según señalan las calculadoras especializadas en coste de agentes, porque ambas técnicas atacan directamente los tokens repetidos, que son los que más se acumulan en conversaciones largas.
Consejo profesional: Fija un presupuesto máximo por percentil 95 (p95) de tokens por sesión, no solo por promedio. Las conversaciones atípicas y largas son las que disparan la factura, y el promedio las esconde.
Medir esto exige monitorear de forma constante los pasos por sesión y el volumen de tokens en los casos más extremos, tal como recomiendan las guías de coste de agentes de IA para evitar facturas sorpresa a fin de mes.
Cómo proyectar el ROI de un agente IA a escala
Escalar el coste por interacción a una proyección mensual o anual es simple en su forma básica: coste por interacción × volumen mensual = coste mensual total. La parte que suele fallar es no aplicar el multiplicador de producción sobre esa cifra base, y terminar presentando un presupuesto que solo cubre la API, no la operación completa.
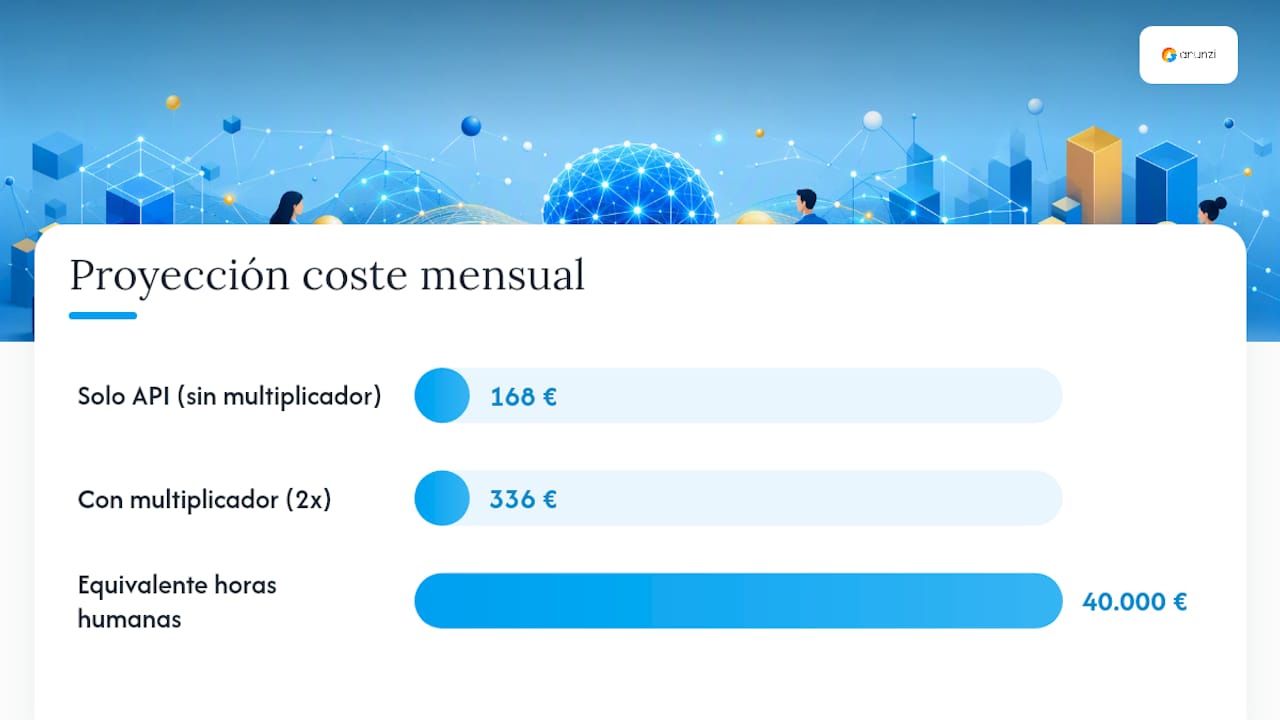
Aplica un rango de entre 1,5x y 3x sobre el coste directo de API para cubrir infraestructura, reintentos y mantenimiento, siguiendo el mismo criterio usado para dimensionar agentes en producción. Con eso, una proyección realista para una empresa con 20.000 interacciones mensuales se vería así:
| Escenario | Coste mensual estimado |
|---|---|
| Solo API (sin multiplicador) | 168 € |
| Con multiplicador de producción (2x) | 336 € |
| Equivalente en horas humanas (a 2 € por interacción) | 40.000 € |
La diferencia entre 336 € y 40.000 € no significa que la IA sustituya cada rol humano por completo, sino que libera capacidad para que los equipos se concentren en los casos que exigen criterio, mientras el agente absorbe el volumen repetitivo. Gartner proyecta que una proporción significativa de las organizaciones de atención al cliente incrementarán su inversión en tecnología en los próximos años, una señal de que este tipo de proyección ya forma parte del presupuesto estándar del sector, no de una apuesta experimental.
Para empresas que operan en varios países de la región, conviene sumar un factor adicional a la proyección: la penetración de WhatsApp en Latinoamérica es alta en la mayoría de los mercados, lo que empuja el volumen de interacciones hacia ese canal específico y condiciona cómo se reparte el presupuesto entre WhatsApp, voz y correo.
Lo que muestran los casos reales de Anunzi en producción
Los números de laboratorio son útiles para presupuestar, pero la prueba real está en operaciones que ya funcionan con volumen.
Ese mismo patrón se repite en otros sectores que ya operan con agentes IA similares:
- Clínicas y equipos comerciales redujeron las llamadas perdidas significativamente.
- Los tiempos de resolución de casos se aceleraron notablemente frente al proceso manual previo.
- La integración se hizo directamente sobre sistemas de CRM y telefonía existentes, sin migraciones forzadas.
- Todo el soporte y despliegue se realizó en español, sin intermediarios ni soporte tercerizado.
Estos resultados importan para el cálculo de costes porque una alta resolución autónoma significa que la gran mayoría de interacciones nunca necesita intervención humana, lo que es la variable que más pesa a la hora de comparar el coste por interacción real, no el teórico, entre un agente IA bien implementado y un equipo humano equivalente.
Lo que la mayoría de guías sobre coste de IA no te dicen
La conversación pública sobre precios de IA se queda casi siempre en el número más pequeño y más vendible: el coste por token. Ese dato es real, pero es la parte menos relevante del presupuesto para cualquier empresa que opere a volumen serio.
Lo que de verdad determina si un proyecto de agentes IA sale rentable o se convierte en un dolor de cabeza financiero es el diseño de los flujos: cuántos pasos necesita un agente para resolver un caso, cuánto contexto acumula y cuántas veces falla y reintenta. Dos empresas pueden usar el mismo modelo y pagar tarifas idénticas por token, y aun así una gastar el triple que la otra solo por la arquitectura de su flujo conversacional.
El consejo que casi nadie da con claridad es este: antes de comparar precios entre proveedores, compara diseños de flujo. Un agente mal diseñado con el modelo más barato del mercado puede costar más que uno bien diseñado con un modelo premium. La disciplina de medir p95, comprimir historial y limitar pasos no es optimización de lujo, es la diferencia entre un presupuesto que se sostiene y uno que se dispara sin avisar.
— Matias
Prueba tu propio caso antes de comprometer presupuesto
Calcular el coste por interacción en una hoja de cálculo es un buen primer paso, pero la cifra que realmente importa es la que sale de tu propio volumen, tus propios flujos y tus propias integraciones con CRM o telefonía.
Si operas por WhatsApp, llamadas de voz o correo, la plataforma de Anunzi IA permite desplegar agentes multicanal integrados a tus sistemas actuales, con el mismo enfoque que ya funciona en municipios y clínicas de España y Argentina.
El siguiente paso concreto es simple: prueba el agente IA en tiempo real y solicita una auditoría de tu consumo actual de tokens antes de ampliar cualquier operación de atención, ventas o cobranzas.
Fuentes
Preguntas frecuentes
¿Cuánto se paga por una IA conversacional?
El coste depende del modelo y el volumen, pero la mayoría de interacciones sencillas cuestan entre 0,002 € y una cifra baja en concepto de API, sin contar infraestructura ni mantenimiento.
¿Cuáles son los precios habituales de la IA por token?
Los proveedores cobran por cada 1.000 o 1.000.000 de tokens y suelen distinguir modelos ligeros, intermedios y de frontera con distintos precios, según explican las comparativas de coste de API.
¿Cuánto se cobra por un chatbot con IA en producción?
El coste total suele ser entre 1,5x y 3x el precio directo de la API, una vez se suman infraestructura, reintentos y mantenimiento, según muestran las guías de coste de agentes en producción.
¿Es más barata la IA que un agente humano en atención al cliente?
En volumen alto, sí: una interacción humana suele costar un rango común entre 1 euro y varios euros, frente a fracciones de céntimo por interacción IA en tareas de primer nivel, aunque los casos complejos siguen requiriendo intervención humana.