Un voicebot no está listo para producción solo porque funcione bien en las demostraciones internas. Antes del lanzamiento hay que simular al menos el doble del pico de concurrencia previsto, medir la latencia en el percentil 99 (no en la media) y confirmar que el time-to-first-audio se mantiene por debajo de 500 ms. Si el sistema no supera esos umbrales bajo carga, el siguiente paso es field testing y monitoreo continuo, no el despliegue.
En resumen:
- Si el voicebot no supera el P99 de latencia de 4 segundos, el time-to-first-audio de 500 ms y la prueba de carga al menos al doble del pico esperado, no debe desplegarse.
- Es esencial realizar pruebas de carga que simulen condiciones reales, incluyendo variaciones en acentos, ruido y canales, para detectar problemas que no aparecen en pruebas funcionales de bajo tráfico.
- La medición de métricas clave como TSR, FCR, MOS y WER debe enfocarse en los percentiles extremos, no solo en la media, para detectar picos que afectarán a usuarios en producción.
- Las pruebas deben incluir field testing con usuarios reales y ruido ambiental para evaluar la robustez del sistema, especialmente en reconocimiento y detección de interrupciones.
- Implementar monitoreo continuo con alertas sobre P99, errores y métricas de negocio asegura detectar fallos antes de que afecten a un volumen significativo de llamadas.
Tabla de contenidos
- Por qué las pruebas de carga son críticas para voicebots
- Métricas clave y objetivos de aceptación para pruebas de carga de voicebots
- Cómo diseñar pruebas de carga realistas para voicebots
- Artefactos de prueba: audio, entornos y escenarios que no deben faltar
- Herramientas y frameworks útiles para pruebas de voz
- Ejecución práctica de un test de carga: checklist operativo y análisis de resultados
- Monitoreo y validación continua en producción (incluyendo ‘LLM as a judge’)
- Casos reales y lecciones prácticas (E-E-A-T de Anunzi)
- Checklist y plantilla rápida de test de carga para aplicar en proyectos
- Lo que la mayoría de los equipos se equivoca al validar voicebots
- Fuentes
- Preguntas frecuentes
Por qué las pruebas de carga son críticas para voicebots
Un voicebot no se comporta como una API o una interfaz web bajo presión. Cada sesión de voz acumula contexto conversacional, mantiene el estado del diálogo y depende de una cadena de reconocimiento, comprensión y síntesis que se ejecuta en tiempo real. Un pico de tráfico no solo satura servidores: degrada la latencia percibida, y esa latencia es lo que un humano nota como una pausa incómoda o un corte en medio de una frase.
La calidad técnica de un modelo no garantiza adopción cuando los percentiles altos de latencia se disparan bajo carga real. Los fallos típicos que aparecen solo a escala incluyen:
- Colas de audio que retrasan el time-to-first-audio más allá de un segundo.
- Sesiones que pierden contexto cuando el sistema reinicia hilos de conversación.
- Cortes de reconocimiento de voz por saturación del motor de transcripción.
- Timeouts en la integración con el CRM o la telefonía durante el pico.
Estos problemas casi nunca aparecen en pruebas funcionales con tráfico bajo. Solo emergen cuando se somete al sistema a una prueba de carga voicebot diseñada para replicar condiciones de producción reales.
Métricas clave y objetivos de aceptación para pruebas de carga de voicebots
Medir bien empieza por elegir las métricas correctas. Un test de carga voicebot serio combina indicadores de experiencia conversacional con métricas de infraestructura:
- Latencia P95/P99: la mediana engaña. Lo que rompe la experiencia son los picos extremos, no el promedio.
- Time-to-first-audio: el tiempo hasta que el usuario escucha la primera respuesta.
- MOS (Mean Opinion Score): calidad percibida de la voz sintetizada.
- WER (Word Error Rate): tasa de error en el reconocimiento de voz.
- TSR/FCR: tasa de éxito de tarea y resolución en primer contacto.
- Métricas de infraestructura: tasa de errores, timeouts, uso de GPU/CPU en los motores de inferencia.
Consejo profesional: no reportes solo la media de latencia en tus dashboards de QA. Un P99 de 4 segundos escondido detrás de un promedio de 600 ms es exactamente el tipo de problema que revienta en producción y nunca aparece en una demo.
Objetivos orientativos de producción: MOS ~4,3, TSR/FCR superior al 85 %, y time-to-first-audio inferior a 500 ms. Un WER más bajo mejora la precisión de intent, pero el umbral aceptable varía según el canal y el idioma.
Priorizar percentiles sobre medianas no es un capricho estadístico: el P99 representa exactamente las llamadas que un supervisor recibirá como queja al día siguiente.
Cómo diseñar pruebas de carga realistas para voicebots
Diseñar una prueba de carga voicebot exige modelar la canalización completa, desde el reconocimiento de voz hasta la respuesta hablada, no solo el backend de negocio. Las estrategias de pruebas de carga para agentes de IA recomiendan incrementar la concurrencia de forma gradual mientras se monitorizan costos y rendimiento en paralelo.
Un plan de diseño sólido sigue este orden:
- Modela la pipeline completa: incluye ASR, NLU, lógica de negocio, TTS y la acumulación de contexto por sesión activa.
- Define el pico previsto y duplica esa cifra para la prueba de estrés según la recomendación de simular al menos el doble de la concurrencia esperada.
- Programa ramp-ups progresivos que revelen en qué punto exacto degrada el sistema, no solo si sobrevive al pico final.
- Incluye reintentos y timeouts realistas, replicando cómo reacciona un usuario real cuando la llamada se corta o tarda.
- Parametriza utterances y prompts con variabilidad lingüística: modismos regionales, acentos y formas de hablar distintas dentro del mismo idioma.
- Combina streaming real con archivos pregrabados: el streaming valida la latencia end-to-end; los archivos permiten repetir exactamente el mismo insumo para comparar versiones.
- Suma pruebas de DTMF para los flujos que combinan voz con tonos de teclado, especialmente en IVR híbridos.
Cada uno de estos pasos debe ejecutarse contra el entorno más cercano posible a producción, incluyendo la misma configuración de red y telefonía que usarán los usuarios finales.
Artefactos de prueba: audio, entornos y escenarios que no deben faltar
Un banco de pruebas de voz incompleto es la causa número uno de sorpresas en producción. El testing de interfaces de voz exige recopilar grabaciones reales, no solo generar audio sintético limpio en estudio.
Los artefactos mínimos que debe contener cualquier suite de pruebas son:
- Utterances reales y sintéticas, cubriendo distintas edades, géneros y niveles de ruido de fondo.
- Diversidad de acentos y dialectos representativa de la base de usuarios real.
- Variedad de códecs y canales: llamadas por PSTN, VoIP corporativo y WebRTC desde navegador.
- Casos límite de interrupción: el usuario hablando encima del bot (overlapping) y la latencia de detección de actividad de voz (VAD stop-latency).
- Secuencias DTMF de un solo dígito y multi-dígito, incluyendo pulsaciones erróneas o repetidas.
El field testing con ruido real y diversidad demográfica revela problemas de robustez que ningún laboratorio con audio limpio detecta, particularmente en la capacidad del sistema para reconocer cuándo el usuario quiere interrumpir la respuesta del bot.
Herramientas y frameworks útiles para pruebas de voz
No existe una herramienta única que cubra todo el ciclo de pruebas de un voicebot. Los equipos serios combinan automatización en CI/CD con simulación acústica y pruebas en dispositivo real, y cada herramienta cumple un rol distinto:
- Botium funciona bien para automatizar escenarios conversacionales y conectar con infraestructura VoIP o PSTN, permitiendo repetir el mismo guion de prueba en cada despliegue.
- Microsoft Copilot Studio incluye un panel de prueba con modos Speech & DTMF que permite simular tonos de teclado y revisar la transcripción de la respuesta de voz, útil para validar gramáticas y temporizadores DTMF.
- EVA aporta un marco de evaluación end-to-end con dos puntajes complementarios: EVA-A mide precisión y EVA-X mide experiencia conversacional.
El trade-off entre precisión y experiencia es la trampa más común al elegir herramientas: optimizar solo la exactitud de las respuestas puede producir un bot que responde correctamente pero suena robótico o corta al usuario a mitad de frase.
Los simuladores resuelven la repetibilidad y el volumen. El field testing resuelve lo que ningún simulador detecta: cómo se comporta el sistema con un acento real, una línea telefónica con estática y un usuario nervioso.
Ejecución práctica de un test de carga: checklist operativo y análisis de resultados
Ejecutar una prueba de carga voicebot bien diseñada sigue un flujo de fases claramente diferenciadas, cada una con sus propias métricas de interés.
- Preparación: definir entornos aislados, preparar el banco de datos de audio, integrar el gate de aceptación en CI/CD y confirmar el consentimiento para grabaciones de prueba.
- Ramp-up: incrementar la concurrencia de forma progresiva y registrar en qué punto empiezan a subir los tiempos de respuesta.
- Pico: sostener el doble de la concurrencia esperada y medir P95/P99, TSR y tasa de errores.
- Estrés: superar el pico objetivo hasta encontrar el punto de quiebre del sistema.
- Soak (resistencia prolongada): mantener carga sostenida durante horas para detectar fugas de memoria o degradación progresiva.
- Recuperación: verificar cuánto tarda el sistema en volver a los tiempos normales tras liberar la carga.
El análisis correcto correlaciona los percentiles de latencia con el uso de recursos de inferencia y con métricas de negocio como TSR o AHT, en vez de mirar cada indicador de forma aislada. Un P99 alto que coincide con saturación de GPU señala un problema de capacidad; un P99 alto sin saturación de recursos señala un cuello de botella en la orquestación del diálogo.
Monitoreo y validación continua en producción (incluyendo ‘LLM as a judge’)
Pasar la prueba de carga no cierra el trabajo. El enfoque de evaluación continua “LLM as a judge” permite que un modelo evalúe automáticamente muestras de conversaciones reales, calificando coherencia, resolución de la tarea y tono, sin depender exclusivamente de auditorías manuales.
- Configura validadores automáticos que revisen tanto la calidad conversacional como el cumplimiento de objetivos de negocio en cada llamada.
- Define alertas y SLOs centrados en P99 de latencia, MOS y TSR/FCR, no solo en disponibilidad del servicio.
- Usa speech analytics sobre las grabaciones de producción para alimentar el reentrenamiento y detectar patrones de fallo nuevos.
Consejo profesional: no esperes al reporte mensual para detectar una caída de TSR. Un panel con alertas diarias sobre P99 y FCR detecta en horas lo que una revisión trimestral detecta en semanas, cuando ya afectó a miles de llamadas.
Casos reales y lecciones prácticas (E-E-A-T de Anunzi)
La Municipalidad de Villa María puso en operación un agente de voz que hoy gestiona el 100 % de los reclamos ciudadanos, con un despliegue completo en solo cuatro semanas.
Ese resultado no aparece por casualidad. La integración de pruebas E2E, field testing con condiciones reales y monitoreo continuo en cada despliegue es clave antes y después de pasar a producción.
Las lecciones transferibles a cualquier equipo que despliegue voicebots son directas:
- Validar el flujo completo con usuarios reales antes de escalar el volumen de llamadas.
- Medir la resolución autónoma desde el primer día, no solo la disponibilidad técnica.
- Ajustar el sistema con datos de producción real, no solo con pruebas de laboratorio.
Otros despliegues en clínicas y equipos comerciales de España y Argentina reportan reducciones de hasta el 80 % en llamadas perdidas tras aplicar la misma disciplina de pruebas antes del lanzamiento.
Checklist y plantilla rápida de test de carga para aplicar en proyectos
Antes de dar luz verde a un despliegue, conviene reducir todo el proceso a una secuencia mínima verificable.
- Ejecutar pruebas E2E con audio limpio y con ruido, cubriendo todos los canales de entrada.
- Correr la prueba de carga simulando el doble del pico previsto y registrar P99, TSR y MOS.
- Realizar field testing con usuarios reales y dispositivos variados.
- Integrar el gate de aceptación en el pipeline de CI/CD antes de cada release.
- Activar monitoreo continuo con alertas sobre P99, FCR y errores de infraestructura.
| Elemento del informe | Qué debe incluir |
|---|---|
| Resumen ejecutivo | Resultado pase/fallo y riesgo residual |
| Métricas críticas | P99, MOS, TSR/FCR, WER por canal |
| Condiciones probadas | Ruido, acentos, canales, picos de carga |
| Decisión | Aprobar, aprobar con condiciones, o rollback |
Un informe sin criterio de rollback no es un informe de prueba: es una lista de números sin consecuencias operativas.
Lo que la mayoría de los equipos se equivoca al validar voicebots
La conversación sobre pruebas de voicebots suele quedarse atrapada en la precisión del modelo de lenguaje, como si un buen LLM garantizara una buena experiencia telefónica. No es así. La mayoría de los proyectos que fallan en producción pasaron sus pruebas funcionales con audio limpio y nunca simularon el doble del pico real ni midieron el P99 de latencia bajo estrés sostenido.
El error más caro no es técnico, es de secuencia: equipos que hacen field testing antes de validar la carga, o que despliegan monitoreo continuo sin haber definido qué SLO dispara una alerta. El orden importa tanto como las métricas mismas.
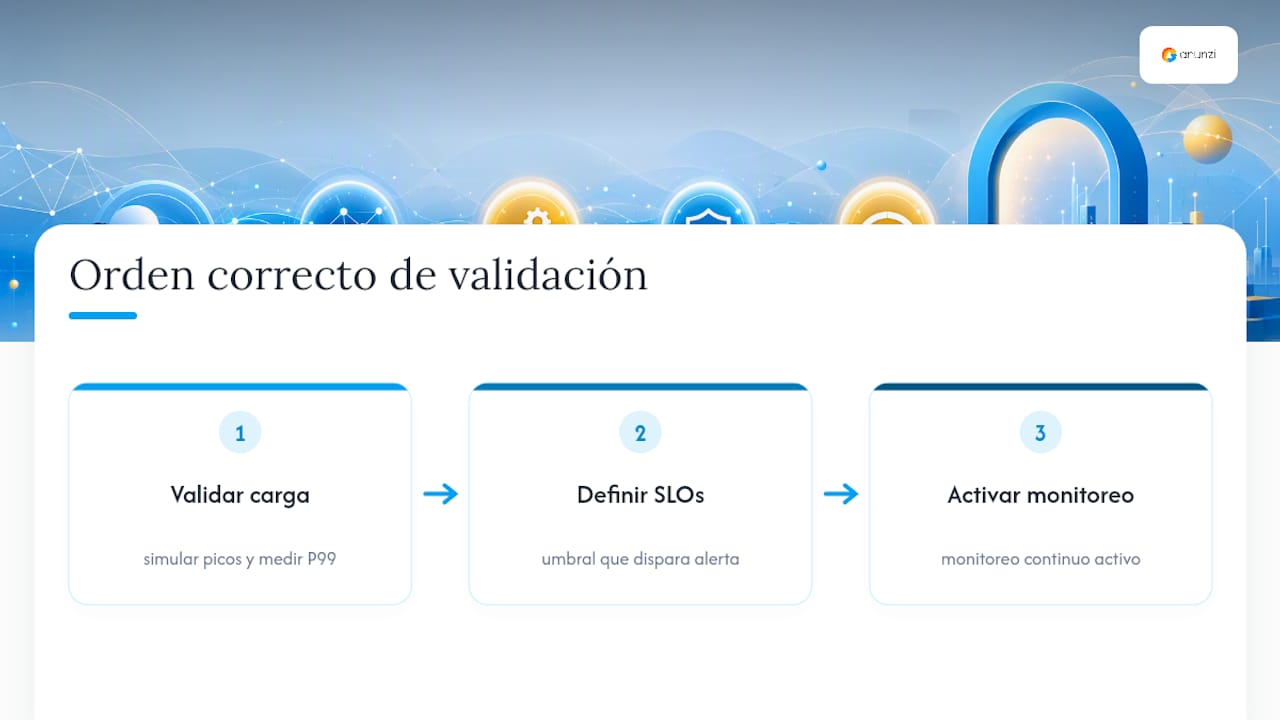
Si algo debería priorizarse primero, es esto: definir el criterio de pase (MOS, TSR, P99) antes de escribir una sola línea de escenario de prueba. Sin ese criterio, cualquier resultado se puede interpretar como “suficientemente bueno”, y esa ambigüedad es exactamente lo que termina fallando frente a usuarios reales.
Antes de comprometer una fecha de lanzamiento, prueba el agente en condiciones controladas y compara sus resultados contra los umbrales de esta guía. Es la forma más rápida de saber si el sistema está listo o si todavía necesita una vuelta más de field testing.
— Matias
Fuentes
- Agente vocal de IA: fiabilidad con la fase de QA – Converteo
- Voice agent evaluation framework: 6 pillars – ElevenLabs
- Prueba de agentes de voz básicos – Microsoft Learn
- EVA: un marco integral para evaluar agentes de voz – Transformación Digital
Preguntas frecuentes
¿Cómo saber si estoy hablando con un voicebot?
Suele notarse en la latencia de respuesta, en pausas antinaturales al inicio de cada turno o en respuestas que no manejan bien interrupciones. Un voicebot bien probado minimiza estas señales, pero rara vez las elimina por completo.
¿Qué es un voicebot?
Un voicebot es un agente de inteligencia artificial que atiende llamadas telefónicas o de voz combinando reconocimiento de habla, comprensión del lenguaje y síntesis de voz para resolver tareas sin intervención humana.
¿Cuál es el objetivo mínimo de latencia en una prueba de carga voicebot?
El objetivo orientativo es un time-to-first-audio inferior a 500 ms, medido en el percentil 99, no en la media de las llamadas.
¿Por qué no basta con probar con audio limpio?
Porque el audio limpio esconde fallos de reconocimiento y de detección de voz (VAD) que solo aparecen con ruido real, acentos distintos y líneas telefónicas de baja calidad.
¿Qué herramientas se usan para probar voicebots antes de lanzarlos?
Botium automatiza escenarios conversacionales y conexiones VoIP, Microsoft Copilot Studio permite probar voz y DTMF desde su panel nativo, y EVA evalúa precisión y experiencia conversacional en pruebas end-to-end.