La prueba de calidad de un agente de IA mide su comportamiento sostenido en producción, no su precisión en un examen puntual: tasa de éxito en tareas completas, consistencia entre ejecuciones, robustez ante fallos de infraestructura y coste por interacción. La prioridad operativa debe combinar fiabilidad y viabilidad económica con cumplimiento normativo, y la recomendación práctica es diseñar pipelines de evaluación continuos desde el primer despliegue, no auditorías puntuales antes de lanzar.
En resumen:
- La evaluación de agentes de IA debe centrarse en su comportamiento sostenido en producción, incluyendo coherencia, recuperación del contexto y uso correcto de herramientas, no solo en respuestas individuales.
- Medir éxito, estabilidad, coste y seguridad en conjunto evita que un agente aparentemente competente sea inviable en operaciones reales por altos costos o fallos recurrentes.
- Combinar evaluación end-to-end, por componentes y en producción, junto con revisiones humanas, proporciona una visión completa y fiable del rendimiento del agente.
- La monitorización continua en producción, con métricas de latencia, coste y tasa de fallo, permite ajustes proactivos y cumplimiento regulatorio en tiempo real.
- Implementar pruebas adversariales y stress testing, incluyendo inyección de fallos y variaciones lingüísticas, ayuda a evaluar la robustez ante condiciones reales y fallos inevitables.
Tabla de contenidos
- Qué es la evaluación de agentes de IA y cómo difiere de la evaluación de modelos
- Métricas clave para pruebas de calidad de agentes de IA
- Enfoques y marcos de evaluación: end-to-end, por componente e híbrida
- Cómo diseñar un plan de pruebas práctico: datos, ground truth y casos de prueba
- Pruebas adversariales y stress testing para evaluar robustez
- Operación y monitorización en producción: métricas continuas y coste
- Cumplimiento, documentación y gestión de riesgo para auditoría
- Casos y pruebas de campo: lecciones desde implementaciones de Anunzi
- Reflexión del autor sobre prioridades estratégicas para evaluación continua
- Opción práctica: validar agentes en producción con el acompañamiento de Anunzi
- Preguntas frecuentes
- Fuentes
Qué es la evaluación de agentes de IA y cómo difiere de la evaluación de modelos
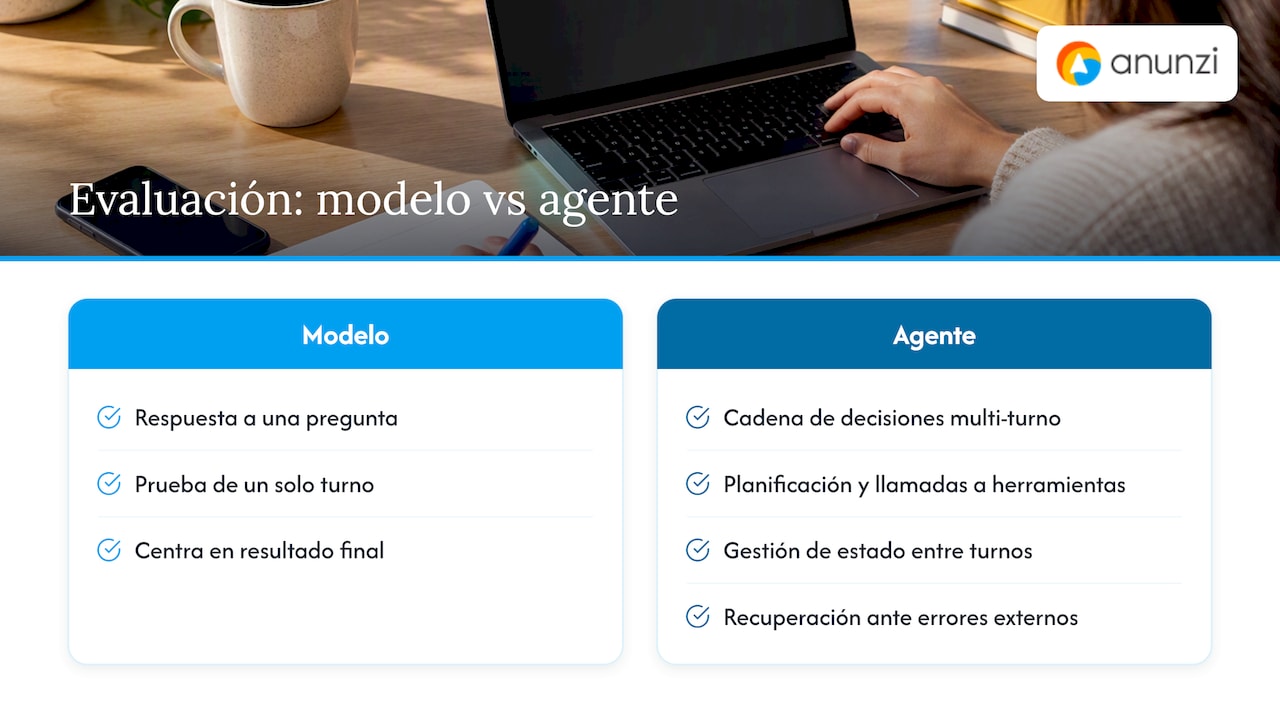
Evaluar un modelo de lenguaje consiste en medir una respuesta frente a una pregunta. Evaluar un agente de IA consiste en medir una cadena de decisiones: planificación, llamadas a herramientas externas, gestión de estado a lo largo de una conversación y recuperación ante errores. Esa diferencia no es cosmética, es estructural, y según la taxonomía propuesta en revisiones académicas recientes, la evaluación de agentes debe cubrir tanto los objetivos del comportamiento (seguridad, fiabilidad, capacidades) como el proceso completo de interacción, incluyendo los datasets y las herramientas de cómputo usadas para generar cada métrica.
Un agente puede responder perfectamente bien a una pregunta aislada y fallar por completo en una conversación de varios turnos, cuando necesita recordar una decisión tomada anteriormente para ejecutar correctamente una acción en turnos posteriores. También puede fallar cuando una API externa devuelve un error inesperado o cuando el usuario cambia de intención a mitad de la conversación. Ninguno de estos fallos aparece en una prueba de modelo clásica, centrada en pares de pregunta y respuesta.
La consecuencia práctica es clara: las pruebas de calidad para agentes de IA deben abandonar las métricas de un solo turno y adoptar métricas de comportamiento sostenido. Esto implica registrar la secuencia completa de acciones, no solo el resultado final, y evaluar si el agente mantiene coherencia, recupera el contexto correcto y ejecuta las herramientas adecuadas en el orden correcto. Según InfoQ, al analizar la evaluación de agentes en entornos de producción, las dimensiones críticas incluyen la resiliencia frente a infraestructura variable, el cumplimiento de políticas internas y la eficiencia operacional, medida en latencia y coste por interacción.
Métricas clave para pruebas de calidad de agentes de IA
Medir la calidad de un agente exige una combinación de indicadores que cubran éxito funcional, estabilidad, coste y seguridad. Ninguna métrica aislada basta: un agente con alta tasa de éxito, pero coste elevado por interacción puede ser inviable en producción, igual que uno rápido y barato pero inconsistente.
- Tasa de éxito de tarea (task success rate): un indicador que mide la proporción de tareas completadas correctamente de principio a fin, sin intervención humana.
- Pass@k y consistencia: ejecutar la misma tarea varias veces y medir cuántas ejecuciones logran el resultado esperado, para detectar variabilidad oculta.
- Robustez: capacidad del agente de mantener rendimiento aceptable ante ruido en el input, cambios de formato o fallos parciales de herramientas externas.
- Rendimiento operativo: latencia total, tiempo hasta el primer token (TTFT), throughput bajo carga y coste por interacción.
- Seguridad y responsabilidad: detección de información personal expuesta, fallos de alineamiento con políticas definidas y registro de incidentes para trazabilidad.
- Indicadores de experiencia: tasa de resolución autónoma, tasa de escalado a un humano y satisfacción medida en la propia interacción.
Según IBM Research, medir eficiencia de recursos y coste por tarea es tan relevante como medir precisión, porque un agente técnicamente capaz puede resultar inviable si es lento o caro en producción. Ese mismo informe señala que benchmarks como PlanBench, MINT o ACPBench evalúan planificación, uso de herramientas y memoria a largo plazo, y casi todos coinciden en que faltan métricas granulares para los pasos intermedios de una tarea, no solo para el resultado final.
En la práctica, un equipo que prioriza solo la tasa de éxito suele descubrir demasiado tarde que el coste por conversación resuelta triplica el de una alternativa más simple. Priorizar coste y latencia desde las primeras pruebas, junto a la tasa de éxito, evita ese descubrimiento tardío y costoso.
Enfoques y marcos de evaluación: end-to-end, por componente e híbrida
Ningún enfoque de evaluación cubre todos los fallos por sí solo. Combinarlos con criterio produce señales reproducibles y útiles para decisiones operativas.
- Evaluación end-to-end: mide el resultado completo de una tarea, desde la intención inicial del usuario hasta la acción final ejecutada. Es la más cercana a la experiencia real, pero cuando falla no indica en qué paso ocurrió el problema.
- Evaluación por componente: aísla cada módulo (comprensión de intención, selección de herramienta, ejecución, generación de respuesta) y lo mide por separado. Facilita la depuración, pero puede ocultar fallos de interacción entre componentes que solo aparecen en conjunto.
- Evaluación offline: se ejecuta sobre datasets controlados antes del despliegue, útil para comparar versiones del agente de forma reproducible.
- Evaluación online: se realiza en producción, con tráfico real o mediante pruebas canario que exponen una nueva versión a un porcentaje reducido de usuarios antes de un despliegue completo.
- LLM-as-a-judge: un modelo de lenguaje adicional evalúa la calidad de las respuestas y trazas de razonamiento del agente, útil para escalar la revisión cuando el volumen de interacciones hace inviable la revisión humana exhaustiva.
InfoQ documenta que los equipos que combinan evaluación automatizada con revisión humana detectan fallos de matiz (tono inapropiado, exceso de confianza, pérdida de contexto) que los sistemas puramente automáticos no identifican. Esa combinación, conocida como evaluación híbrida, es hoy el estándar más sólido para agentes que operan en entornos sensibles como salud, cobranzas o atención ciudadana.
La reproducibilidad exige documentar qué versión del agente, qué dataset y qué configuración de modelo se usaron en cada prueba. Sin ese registro, comparar resultados entre semanas distintas se convierte en un ejercicio de fe, no de ingeniería.
Cómo diseñar un plan de pruebas práctico: datos, ground truth y casos de prueba
Un plan de pruebas útil empieza por decidir qué cuenta como respuesta correcta.
- Ground truth factual: una respuesta objetivamente verificable, útil para tareas de consulta de datos o cálculo.
- Ground truth referencial: comparación contra una respuesta de referencia escrita por un experto, útil cuando hay varias formas válidas de responder.
- Ground truth basado en criterios: una rúbrica que evalúa dimensiones como claridad, tono o cumplimiento de política, en lugar de una única respuesta correcta.
- Verificación por comportamiento: comprobar que el agente ejecutó los pasos correctos (llamó a la herramienta adecuada, en el orden adecuado), independientemente del texto final generado.
Los casos de prueba deben incluir escenarios reales capturados de producción y casos límite diseñados deliberadamente: combinaciones inusuales de inputs, fallos simulados de API, sesiones largas donde el agente debe recordar decisiones tomadas varios turnos antes. Un dataset que solo contiene preguntas ideales y bien formadas no detecta los fallos que realmente importan.
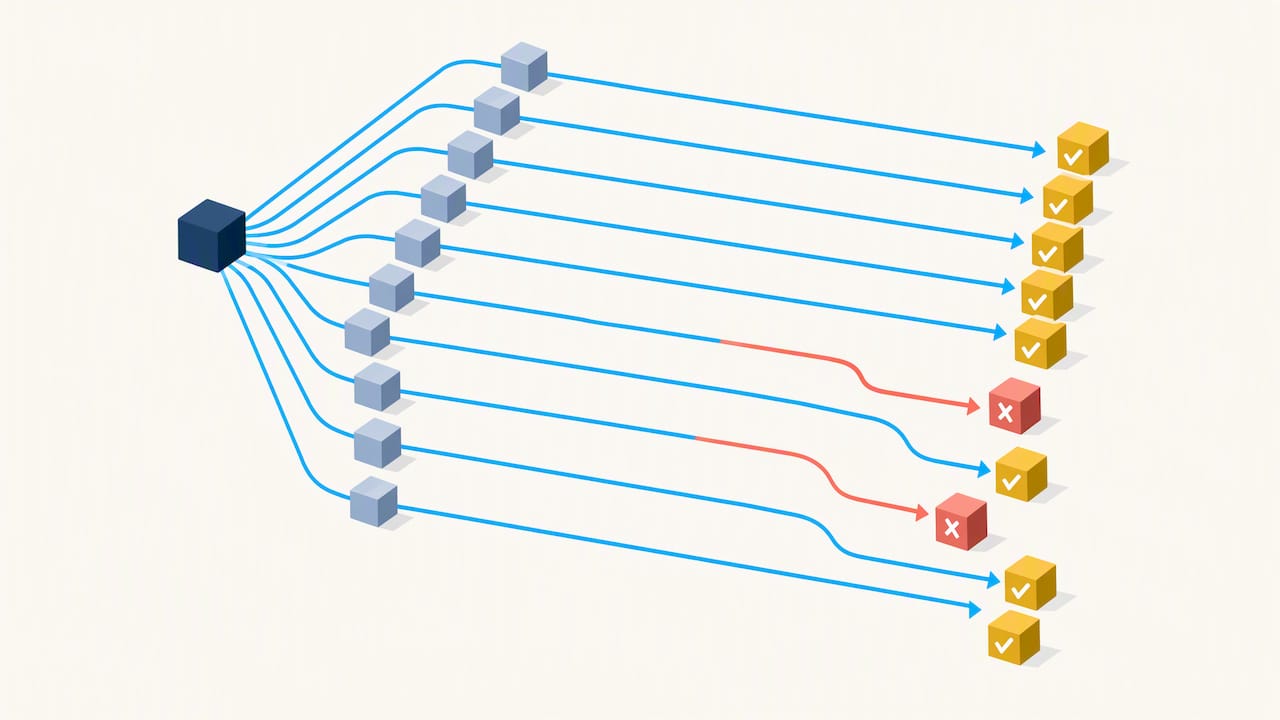
La estrategia de replicación, ejecutar la misma tarea varias veces (pass@k) y medir la variabilidad entre ejecuciones, revela si el comportamiento observado es estable o producto del azar. Un agente que acierta nueve de diez ejecuciones idénticas tiene un perfil de riesgo distinto al de uno que acierta siempre o nunca.
Consejo profesional: guarde cada versión del dataset de pruebas junto con la versión del agente evaluada: sin ese vínculo, ningún resultado histórico es comparable con el actual.
Para equipos que integran agentes con sistemas de telefonía o CRM, la arquitectura de integración condiciona directamente qué casos de prueba son relevantes, porque los fallos de integración (desconexiones, latencia de red, timeouts de API) suelen superar en frecuencia a los fallos de comprensión del lenguaje.
Pruebas adversariales y stress testing para evaluar robustez
Un agente que funciona bien en condiciones ideales no garantiza nada sobre su comportamiento bajo presión real. Las pruebas adversariales existen precisamente para forzar esas condiciones antes de que ocurran con un cliente real.
- Parafraseo y variaciones lingüísticas: reformular la misma intención con sinónimos, errores ortográficos o registros distintos (formal, coloquial, regional) para medir si el agente mantiene la comprensión.
- Inyección de fallos (fault injection): simular latencias elevadas, errores de API, respuestas malformadas o caídas parciales de infraestructura, para observar cómo reacciona el agente ante condiciones que ocurrirán inevitablemente en producción.
- Red teaming: intentos deliberados de inducir al agente a comportamientos no deseados, revelar información sensible o eludir restricciones de política, ejecutados de forma sistemática y documentada.
- Medición de degradación y recuperación: trazar cómo cae el rendimiento bajo cada perturbación y, más importante, cuánto tarda el agente en recuperar un comportamiento correcto tras el fallo.
El objetivo no es que el agente nunca falle, eso es poco realista en sistemas que dependen de APIs externas y de lenguaje natural ambiguo. El objetivo es que falle de forma predecible, se recupere con rapidez y nunca comprometa datos sensibles ni ejecute una acción irreversible sin verificación. Un agente que detecta su propia incertidumbre y escala a un humano es preferible, en términos de riesgo, a uno que siempre responde con la misma confianza aparente.
Operación y monitorización en producción: métricas continuas y coste
Las pruebas previas al lanzamiento predicen el comportamiento del agente, pero solo la monitorización en producción confirma si esa predicción se sostiene con tráfico real, usuarios reales y la variabilidad propia del día a día operativo.
- Panel mínimo de control: cumplimiento de SLA, latencia por interacción, coste por tarea resuelta, tasa de éxito y tasa de escalado a un agente humano.
- Observabilidad con trazas: cada interacción debe quedar registrada con su cadena completa de decisiones, para poder correlacionar un incidente puntual con su causa técnica.
- Alertas automatizadas: umbrales que disparan una revisión cuando la latencia, el coste o la tasa de fallo se desvían de su rango habitual.
- Optimización de coste y latencia: técnicas como caché de respuestas frecuentes, agrupación de solicitudes (batching), ajuste de la temperatura del modelo y delegación de tareas simples a modelos más ligeros.
La reducción del tiempo medio de atención documentada por Anunzi ilustra cómo el monitoreo continuo de métricas operativas permite ajustar un agente en producción, no solo validarlo antes del lanzamiento.
Conservar el historial completo de interacciones, decisiones y resultados cumple una doble función: permite depurar un fallo semanas después de que ocurrió y constituye la evidencia que una auditoría regulatoria o un cliente exigente terminará pidiendo.
Cumplimiento, documentación y gestión de riesgo para auditoría
La evaluación de agentes de IA ya no es solo una práctica de ingeniería, es también una obligación regulatoria en mercados que adoptan marcos como el AI Act europeo. El artículo 9 del AI Act exige a los proveedores de sistemas de alto riesgo mantener un sistema de gestión de riesgos activo y documentar los escenarios de prueba, los resultados obtenidos y las medidas correctivas aplicadas.
- Gestión de riesgos continua: no es un informe único, es un proceso que se revisa con cada cambio relevante del agente o de su entorno de operación.
- Documentación técnica detallada: inputs recibidos, razonamiento intermedio, cada llamada a herramienta ejecutada y el resultado final de cada interacción.
- Registro de incidentes: cualquier comportamiento fuera de lo esperado debe quedar documentado con suficiente detalle para análisis posterior.
- Integración en el ciclo de pruebas: el cumplimiento no se añade al final, se incorpora como parte del pipeline de evaluación desde el diseño inicial.
El protocolo MEG propone mecanismos concretos para cerrar lo que denomina la brecha de responsabilidad en agentes autónomos: métricas dinámicas de verificación en tiempo de ejecución y un registro inmutable de decisiones, comparable a una caja negra de vuelo aplicada a sistemas de IA. Esa misma lógica, aunque un equipo no opere bajo jurisdicción europea, es una práctica sólida: la documentación generada para pasar una auditoría es, casi siempre, la misma que un equipo necesita para depurar sus propios fallos.
Casos y pruebas de campo: lecciones desde implementaciones de Anunzi
La teoría de evaluación se confirma o se descarta en despliegues reales. Clínicas y equipos comerciales que operan con agentes en España y Argentina reportan reducciones significativas en llamadas perdidas y aceleraciones en los tiempos de resolución.
- Métricas seguidas en campo: tasa de resolución autónoma, llamadas perdidas evitadas y tiempo de resolución por caso.
- Lección sobre instrumentación: los resultados solo fueron medibles porque cada interacción quedó registrada desde el primer día, no añadida después como mejora.
- Lección sobre iteración: los ajustes de mayor impacto surgieron de revisar casos de escalado a humano, no de los casos resueltos sin fricción.
- Lección sobre plazos: un despliegue de cuatro semanas es viable cuando el pipeline de pruebas está definido antes de integrar el agente al canal de producción.
Reflexión del autor sobre prioridades estratégicas para evaluación continua
La trampa más común no es elegir una métrica equivocada, es tratar la evaluación como un trámite previo al lanzamiento en lugar de una disciplina permanente con responsables claros. Un agente que pasó todas las pruebas en marzo puede degradarse en junio porque cambió una API externa, cambió el comportamiento de los usuarios o simplemente se acumuló deuda técnica nadie revisó.
Tampoco confíes solo en la automatización. El LLM-as-a-judge escala la revisión, pero el red teaming periódico y la revisión humana de casos límite siguen detectando matices que ningún sistema automático capta todavía. La organización que entiende esto no pregunta “¿pasó la prueba?”, pregunta “¿quién revisa esto la próxima semana?”.
— Matias
Opción práctica: validar agentes en producción con el acompañamiento de Anunzi
Diseñar un pipeline de evaluación continuo desde cero exige tiempo, instrumentación y un equipo dedicado que muchas organizaciones no tienen disponible de forma inmediata. Se implementan agentes de IA ya integrados con CRM, telefonía y sistemas de pago, con trazabilidad y monitorización incorporadas desde el primer despliegue, no como una capa añadida después. El soporte y el acompañamiento se ofrecen en español, con equipo propio en Argentina y España, lo que evita depender de soporte genérico en otro idioma durante una fase crítica de ajuste.
Si tu equipo está evaluando si construir evaluación interna o apoyarse en una implementación ya validada en campo, con casos documentados en municipios, clínicas y equipos comerciales, podés probar un agente en tiempo real antes de decidir. Es la forma más directa de ver cómo se comporta un agente bajo condiciones reales, no solo en una demo controlada.
Preguntas frecuentes
¿Cuáles son los 5 tipos principales de agentes de IA?
Las clasificaciones habituales distinguen agentes reactivos simples, agentes basados en modelos, agentes basados en objetivos, agentes basados en utilidad y agentes de aprendizaje, según su capacidad de planificación y adaptación. En la práctica operativa, lo relevante no es la categoría teórica , sino si el agente mantiene estado, usa herramientas externas y opera en múltiples turnos.
¿Qué prueba puedo usar para medir mi inteligencia artificial?
No existe una única prueba universal: combina tasa de éxito de tarea, pruebas de consistencia con múltiples ejecuciones (pass@k), pruebas adversariales con ruido e inyección de fallos, y métricas operativas de latencia y coste por interacción. La evaluación híbrida que combina automatización con revisión humana suele detectar más fallos reales que cualquier prueba aislada.
¿Cuáles son los mejores agentes de IA?
Depende por completo del caso de uso: un agente de voz para atención ciudadana se evalúa con criterios distintos a uno de ventas por WhatsApp o uno de cobranzas. Se han documentado resultados en producción en municipios y empresas de España y Argentina, con integración directa a los sistemas propios de cada cliente en lugar de un chatbot genérico.
¿Cuáles son los tipos de evaluación según el agente?
Los principales son evaluación end-to-end (resultado completo de la tarea), evaluación por componente (cada módulo por separado), evaluación offline (sobre datasets controlados antes del despliegue) y evaluación online (con tráfico real en producción, incluyendo pruebas canario). La mayoría de equipos maduros combina varios de estos enfoques en lugar de apoyarse en uno solo.
Fuentes
- Evaluating AI agents in practice: lessons learned (InfoQ)
- A 360 review of AI agent benchmarks (IBM Research)
- AI Act — Article 9 (AI Act Service Desk)
- Bridging the ‘Accountability Gap’ in Agentic AI (MEG)
- The rise of LLM-based agents: taxonomy and evaluation (arXiv)